GPT-6 Luna API 전환 전 확인할 것: 비용·도구 호출 조건과 이미지 재시험
GPT-6 Luna로 자동화를 옮기기 전에 모델 이름만 바꿔도 되는지 확인해 보세요. 짧은 분류나 정보 추출은 비용을 비교하기 좋지만, 도구를 호출한다면 연결 방식과 추론 설정도 맞춰야 해요. 사진을 읽는 작업을 9월 말에 시험했다면 당시 실패 결과도 다시 확인해 보세요.
2026년 10월 2일 OpenAI 공식 API 문서를 기준으로 GPT-6 Sol과 GPT-6 Luna의 전환 조건과 비용을 확인해 보세요. 9월 29일 나온 GPT-6.1 Sol은 모델 ID가 다르니 따로 구분해 주세요. 문서의 지원 조건과 비용 계산으로 모든 업무의 실제 성능을 확인한 것은 아니니, 사용하려는 업무에서도 결과를 시험해 보세요.
모델 이름과 Luna 비용부터 확인해 보세요. 도구 호출 조건과 사진 입력을 시험한 뒤, 추론 비용과 미완료 응답도 살펴보며 작은 업무부터 옮겨 보세요.
이름에 6.1이 붙었는지 먼저 봅니다
API 요청에서 GPT-6 Sol은 gpt-6-sol, GPT-6 Luna는 gpt-6-luna입니다. 이름이 비슷한 gpt-6.1-sol의 설명이나 요금표를 그대로 복사해 Luna에 붙이면 안 됩니다. 자동화 서비스의 화면에 ‘Sol’만 적혀 있다면 실제 요청에 들어간 model 값을 따로 확인하는 편이 정확합니다.
두 모델은 2026년 9월 22일 공개됐습니다. OpenAI는 Sol을 복잡한 코딩과 에이전트 작업에, Luna를 범위가 분명하고 많은 양을 처리하는 작업에 맞춘 모델로 소개합니다. 이 설명만으로 내 업무의 정확도까지 같다고 볼 수는 없습니다. 이메일을 몇 개의 유형으로 나누는 일과, 여러 문서를 대조해 예외를 판단하는 일은 요구하는 결과가 다릅니다.
가령 문의를 배송·환불·계정으로 분류한다면 라벨 목록과 ‘어느 쪽인지 불분명함’이라는 선택지를 먼저 정할 수 있습니다. 반대로 답변을 실제 고객에게 보내는 단계에는 주문 상태 확인과 문장 검수가 필요합니다. 같은 자동화 안에서도 분류와 외부 발송을 하나의 난도로 묶지 않는 것이 전환 범위를 고르기 쉽습니다.
Luna의 출력은 100만 토큰당 0.50달러입니다
Standard 기본 단가는 100만 토큰당 Luna 입력 0.10달러, 캐시 입력 0.01달러, 출력 0.50달러입니다. 같은 기준의 GPT-6 Sol은 입력 2달러, 캐시 입력 0.20달러, 출력 10달러입니다. 숫자 하나만 적어 놓기보다 입력과 출력을 나눠 적어야 예상 금액이 보입니다.
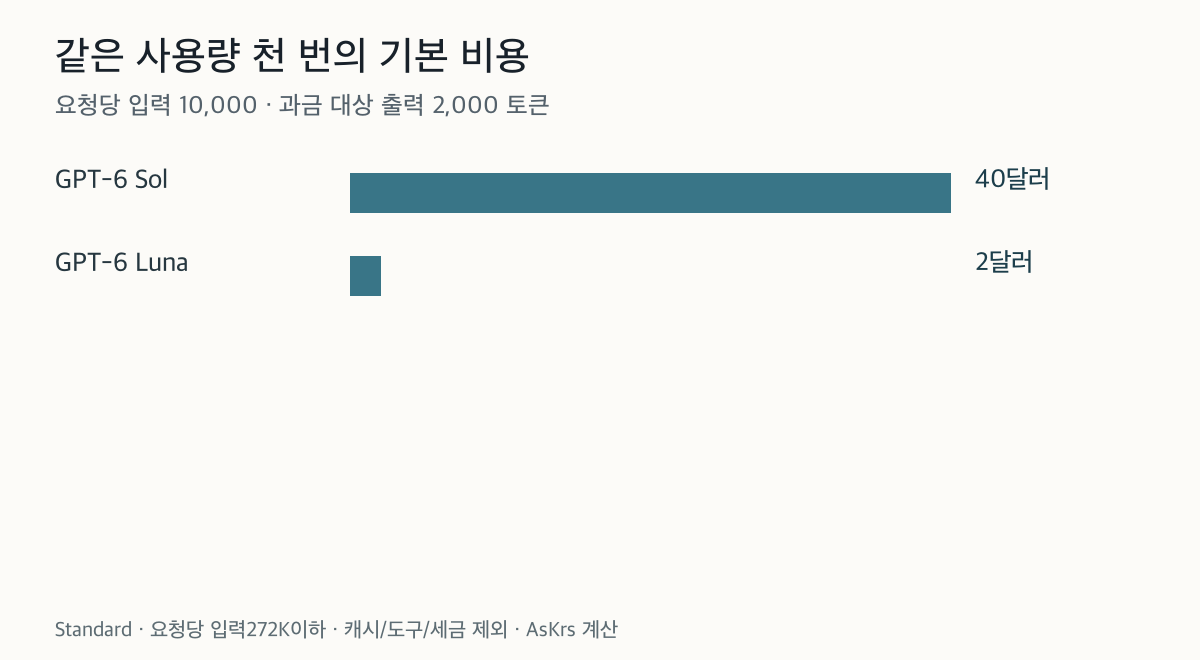
각 요청의 입력 1만·전체 출력 2천 토큰, 캐시 없는 Standard 기준을 천 번 합산한 계산입니다. 도구·캐시 쓰기·세금·환율은 제외했습니다.
계산 예시로 요청 하나의 캐시 없는 입력이 1만 토큰, 과금 대상 출력이 2천 토큰이라고 가정하겠습니다. Luna는 입력 0.001달러와 출력 0.001달러를 더해 기본 토큰 비용이 0.002달러입니다. Sol은 같은 사용량에서 0.02달러와 0.02달러, 합계 0.04달러입니다. 단가로만 계산한 차이는 20배지만, 결과의 정확도나 사람이 고치는 시간까지 20배 차이라는 뜻은 아닙니다.
이 크기의 요청을 천 번 처리하고 매번 같은 사용량이 나왔다고 가정하면 Luna 2달러, Sol 40달러입니다. 입력을 천 번 합산한 1천만 토큰과 요청 하나의 길이를 혼동하지 않아야 합니다. 이 예시는 각 요청의 입력이 1만 토큰인 경우이지, 한 번에 1천만 토큰을 넣는 예시가 아닙니다.
여기에는 캐시 쓰기, 검색 등 도구 비용, 세금과 환율을 넣지 않았습니다. 실제 사용량이 같다는 가정도 계산을 보여주기 위한 것입니다. 모델을 바꾸면서 답이 길어지거나 재시도가 늘면 월 비용은 이 예시대로 나오지 않습니다. 단가가 낮은 쪽을 고른 뒤에도 성공한 결과 한 건에 얼마가 들었는지 비교할 필요가 있습니다.
기본 요금과 긴 요청의 경계도 따로 있습니다. Luna 문서는 입력이 272K 토큰을 넘는 요청에 입력·캐시 2배, 출력 1.5배가 전체 요청에 적용된다고 설명합니다. 1,050,000토큰의 문맥 한도와 128,000토큰의 최대 출력은 용량이고, 기본 단가가 유지되는 경계는 다른 숫자입니다. 큰 자료를 처리할 때는 한도에 들어가는지와 요금 조건을 각각 확인합니다.
Chat Completions에 도구를 붙였다면 none 조건이 있습니다
GPT-6 Sol과 Luna의 모델 문서는 내장 도구와 함수 호출에 Responses API를 사용하도록 안내합니다. Chat Completions에서도 함수 호출을 지원하지만 reasoning_effort가 none인 경우로 제한합니다. ‘Chat Completions를 지원함’이라는 항목만 보고 기존 설정을 그대로 가져오면 이 조건을 놓치기 쉽습니다.
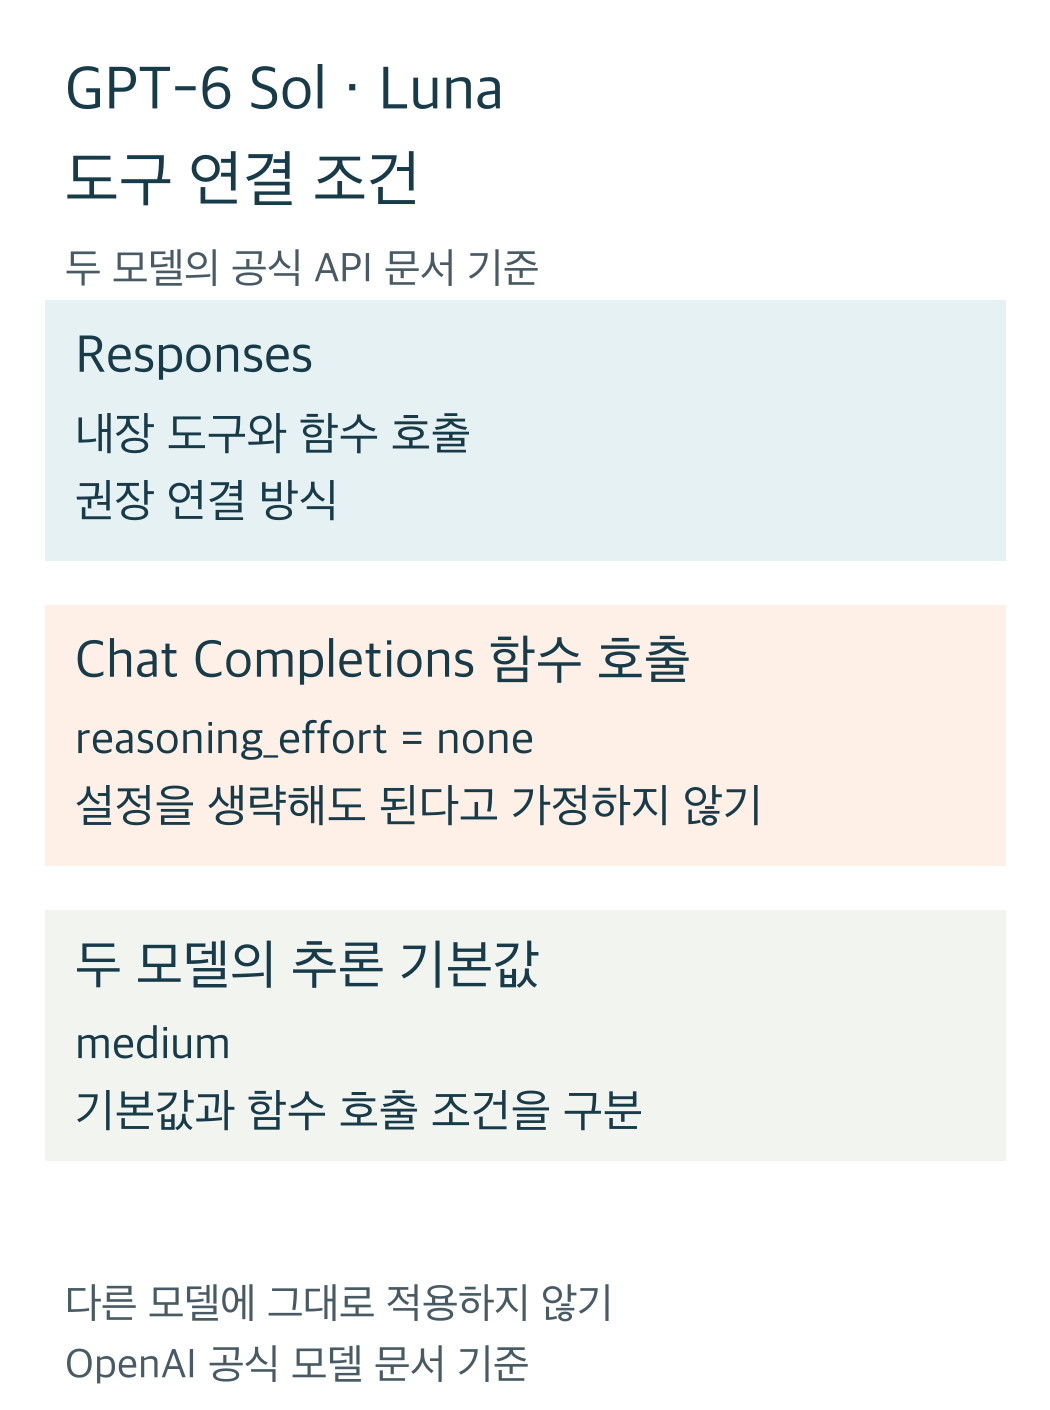
GPT-6 Sol/Luna의 공식 조건입니다. Chat Completions 함수 호출에 추론 설정을 생략해도 괜찮다고 가정하지 않습니다.
예를 들어 기존 요청이 Chat Completions, reasoning_effort=medium, 주문조회 함수의 조합이었다면, Luna 이름으로 교체하기 전에 연결 방식을 다시 검토해야 합니다. Responses에서는 reasoning.effort처럼 설정 위치도 달라집니다. 값 하나를 바꾸는 문제와 요청 형식을 옮기는 문제를 나눠 봐야 엉뚱한 곳을 고치지 않습니다.
두 모델의 추론 노력은 none·low·medium·high·xhigh·max이며 기본값은 medium입니다. 따라서 함수 호출이 필요한 Chat Completions 요청에서 추론 값을 생략해도 괜찮겠지 하고 가정하지 않는 편이 좋습니다. 이 조건은 이 글에서 다루는 GPT-6 Sol/Luna의 문서를 기준으로 한 것이며, 다른 모델의 지원 범위까지 같다고 뜻하지 않습니다.
함수 이름을 응답으로 받았다고 조회나 발송이 끝난 것도 아닙니다. 공식 함수 호출 흐름은 모델의 호출 요청을 받은 뒤 애플리케이션이 코드를 실행하고, 그 결과를 다시 모델에 보내는 구조입니다. 주문조회 예시라면 주문번호를 받은 단계, 내 서버가 조회한 단계, 최종 답을 만든 단계가 따로 있습니다.
처음 연결할 함수는 조회처럼 되돌릴 문제가 작은 동작이 편합니다. 외부 발송까지 시험한다면 받는 사람과 본문을 확인하는 단계를 분리할 수 있습니다. 응답에 ‘보냈습니다’라는 문장이 있는지를 성공 기준으로 삼기보다, 실제 전송 결과와 조회 결과를 남기는 쪽이 자동화 점검에 도움이 됩니다.
9월 25일 이전 사진 시험이 실패했다면 다시 볼 만합니다
OpenAI API 변경 기록에는 2026년 9월 25일 Sol과 Luna의 이미지 인코딩 버그를 수정했다고 나옵니다. 이미지 이해 성능에 영향을 주던 문제였으며, API와 Codex의 시각 작업을 개선한다는 설명입니다. 이미지 입력을 쓰는 경우 평가를 다시 실행하고 영향을 받은 작업을 재시도하라는 권고도 함께 있습니다.
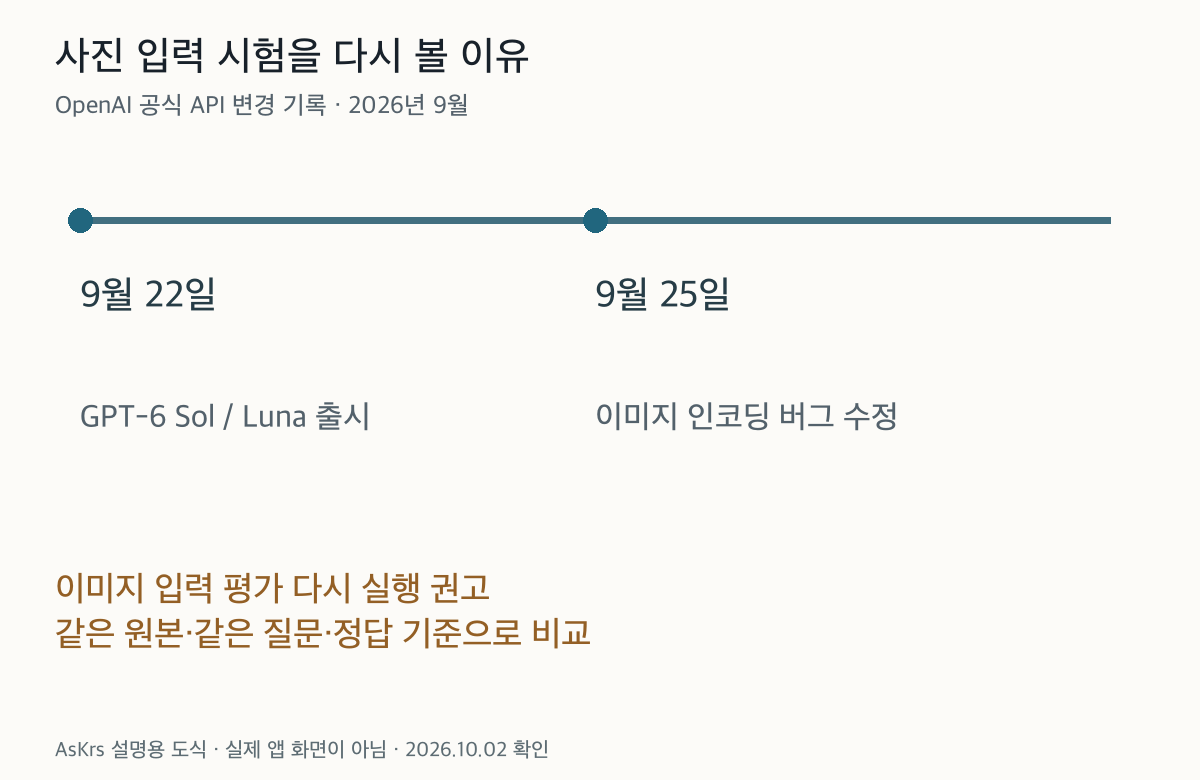
9월 25일 수정 이전의 이미지 시험 결과라면 같은 자료로 다시 평가할 이유가 있습니다. 수정 소식만으로 모든 사진의 정확도를 보장하지는 않습니다.
영수증에서 날짜와 금액을 읽거나, 화면에서 버튼 위치를 찾는 자동화를 그 전에 시험했다면 같은 자료로 다시 비교할 이유가 있습니다. 다만 수정 소식이 모든 사진을 정확히 읽게 됐다는 보장은 아닙니다. 예전 실패가 모델 버그 때문인지 원본 흐림 때문인지도 실제 결과로 나눠 봐야 합니다.
재시험할 자료는 잘 나온 사진만 고르지 않습니다. 보통 크기의 글씨, 흐릿한 숫자, 세로로 긴 화면처럼 원래 업무에서 자주 만나는 자료를 구분해 놓고 정답을 적습니다. 예를 들어 영수증 날짜가 틀린 경우와 합계가 틀린 경우를 따로 세면, 일부 항목은 좋아졌지만 다른 항목은 그대로라는 결과도 볼 수 있습니다. 이는 공급사가 제시한 점수가 아니라 내 업무를 확인하는 방법입니다.
비교 중에는 원본 이미지, 질문, 필요한 출력 항목을 같게 두는 편이 차이를 해석하기 쉽습니다. 모델도 바꾸고 사진도 다시 찍고 질문도 길게 바꾸면 무엇 때문에 개선됐는지 알기 어렵습니다. 개인정보가 있는 원본을 그대로 공유하지 말고, 시험에 필요한 정보와 사용 권한도 먼저 확인합니다.
Sol과 Luna의 기본 입출력은 텍스트·이미지 입력과 텍스트 출력입니다. 사진을 이해한다고 사진 파일을 직접 생성하는 같은 기능은 아닙니다. 이미지 생성 도구를 연결하는 경우에는 그 도구의 실행과 비용을 따로 살펴야 합니다.
보이는 답변 길이만으로 출력 비용을 계산하지 않습니다
추론 모델은 사용자에게 보이는 문장 외에 추론 토큰을 사용합니다. OpenAI의 추론 문서는 이 토큰도 출력으로 과금되며 문맥 공간을 차지한다고 설명합니다. 답이 다섯 줄이라고 해서 비용도 그 다섯 줄만으로 결정된다고 계산하면 실제 사용량과 어긋날 수 있습니다.
응답의 usage에 있는 output_tokens와 output_tokens_details의 reasoning_tokens를 함께 확인합니다. 앞의 비용 예시는 과금 대상 출력 전체가 2천 토큰이라고 가정한 계산입니다. 보이는 문장이 2천 토큰이라는 뜻으로 바꾸면 같은 예시가 아닙니다. 입력·출력 수치는 문장의 글자 수가 아니라 실제 사용량으로 기록해야 합니다.
max_output_tokens에 도달하면 status가 incomplete이고 이유가 max_output_tokens인 응답이 나올 수 있습니다. 눈에 보이는 답이 나오기 전에 추론에서 한도를 쓸 수도 있습니다. 이 경우를 빈 답변이니 무료였다고 보거나, 완료된 결과로 저장하면 안 됩니다. 미완료 상태와 사용량을 함께 남겨야 재시도 이유를 설명할 수 있습니다.
무조건 출력을 작게 제한하는 것보다 필요한 결과의 범위부터 좁히는 편이 낫습니다. 분류 업무라면 긴 해설 대신 라벨과 근거 위치만 요청할 수 있습니다. 그런데 문서 대조처럼 이유가 필요한 일을 같은 방식으로 줄이면 검수할 단서가 사라질 수 있습니다. 절약한 비용과 확인할 수 없게 된 내용을 같이 봅니다.
한 가지 업무의 성공 기준을 적고 옮깁니다
첫 전환 대상으로는 정답을 확인하기 쉬운 작업을 고릅니다. 문의 분류라면 라벨이 맞는지, 예약번호 추출이라면 원문과 한 글자도 다른 곳이 없는지부터 정합니다. ‘그럴듯한 답이 나옴’보다 실패를 세기 쉬운 기준이 있어야 Luna를 써도 되는 범위가 보입니다.
기록에는 실제 모델 ID, API 연결 방식, 추론 설정, 입력·출력·캐시 사용량과 완료 상태를 함께 남깁니다. 처음에는 작은 시험 묶음에서 비교하고, 비용뿐 아니라 틀린 결과를 찾는 시간도 확인합니다. 결과가 좋지 않은 항목은 더 긴 설명을 붙여 덮기보다 원문, 도구 결과, 질문 중 어느 단계가 부족한지 구분합니다.
Luna로 모든 단계를 한꺼번에 바꿀 필요는 없습니다. 분류는 Luna로 처리하되 판단이 어려운 항목은 사람이 확인하거나 별도 검토 단계로 보내는 식으로 범위를 정할 수 있습니다. 연결 조건과 실제 사용량을 확인한 뒤에 처리량을 늘려야, 싸게 시작한 자동화가 반복 실패 때문에 오히려 비싸지는 일을 줄일 수 있습니다.