Gemini 3.8 TTS 9월 23일 공개, 30초 음성으로 목소리 복제까지 됩니다
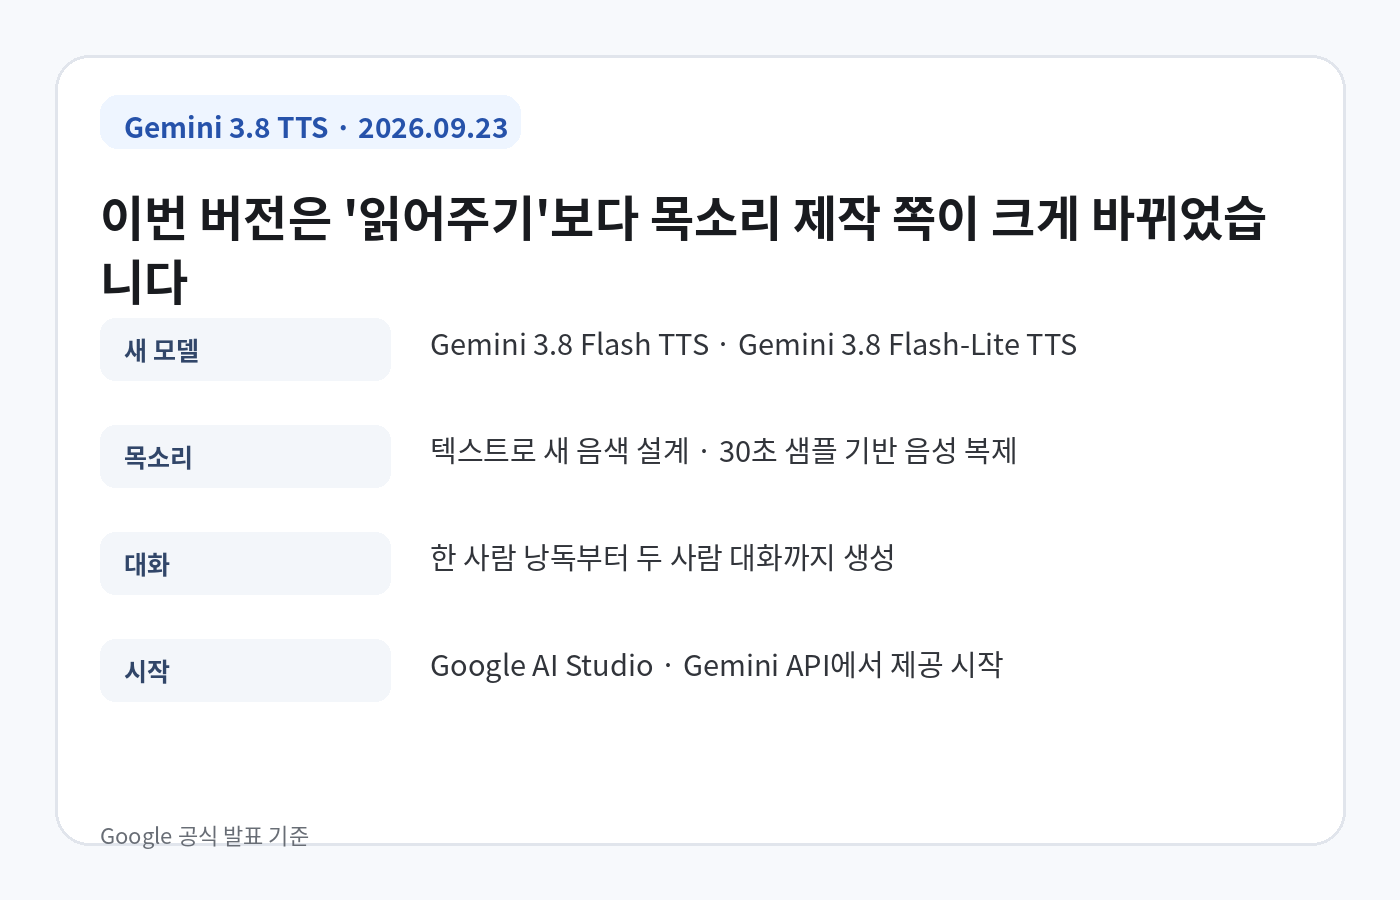
AI 음성 생성이 단순히 문장을 읽어주는 수준에서 한 단계 더 넘어갔습니다. Google이 9월 23일 Gemini 3.8 Flash TTS와 Flash-Lite TTS를 공개했고, Google AI Studio와 Gemini API에서 제공을 시작했습니다.
이번 버전에서 눈에 띄는 건 목소리 자체를 새로 설계하거나, 약 30초짜리 음성 샘플을 이용해 같은 화자의 목소리를 재현할 수 있다는 점입니다. 한 사람 내레이션뿐 아니라 두 사람이 주고받는 대화도 만들 수 있고, 대사마다 속도나 감정 같은 전달 방식을 따로 지정할 수 있습니다.
Flash와 Flash-Lite, 이름은 비슷해도 쓰는 곳이 다릅니다
둘 중 하나를 고를 때는 음질과 표현력을 우선할지, 대량 생성 효율을 우선할지만 보면 됩니다. Google은 Flash TTS를 복잡한 다중 화자 대화, 세밀한 연기 지시, 발음이 까다로운 원고, 장시간 내레이션 같은 작업에 권장하고 있습니다.
Flash-Lite TTS는 반복해서 많은 음성을 만들어야 할 때가 맞습니다. 읽어주기 기능, 음성 에이전트, 대량 콘텐츠 제작, 일상적인 한 사람 음성 생성처럼 처리량과 효율이 중요한 작업을 기준으로 설계됐습니다.
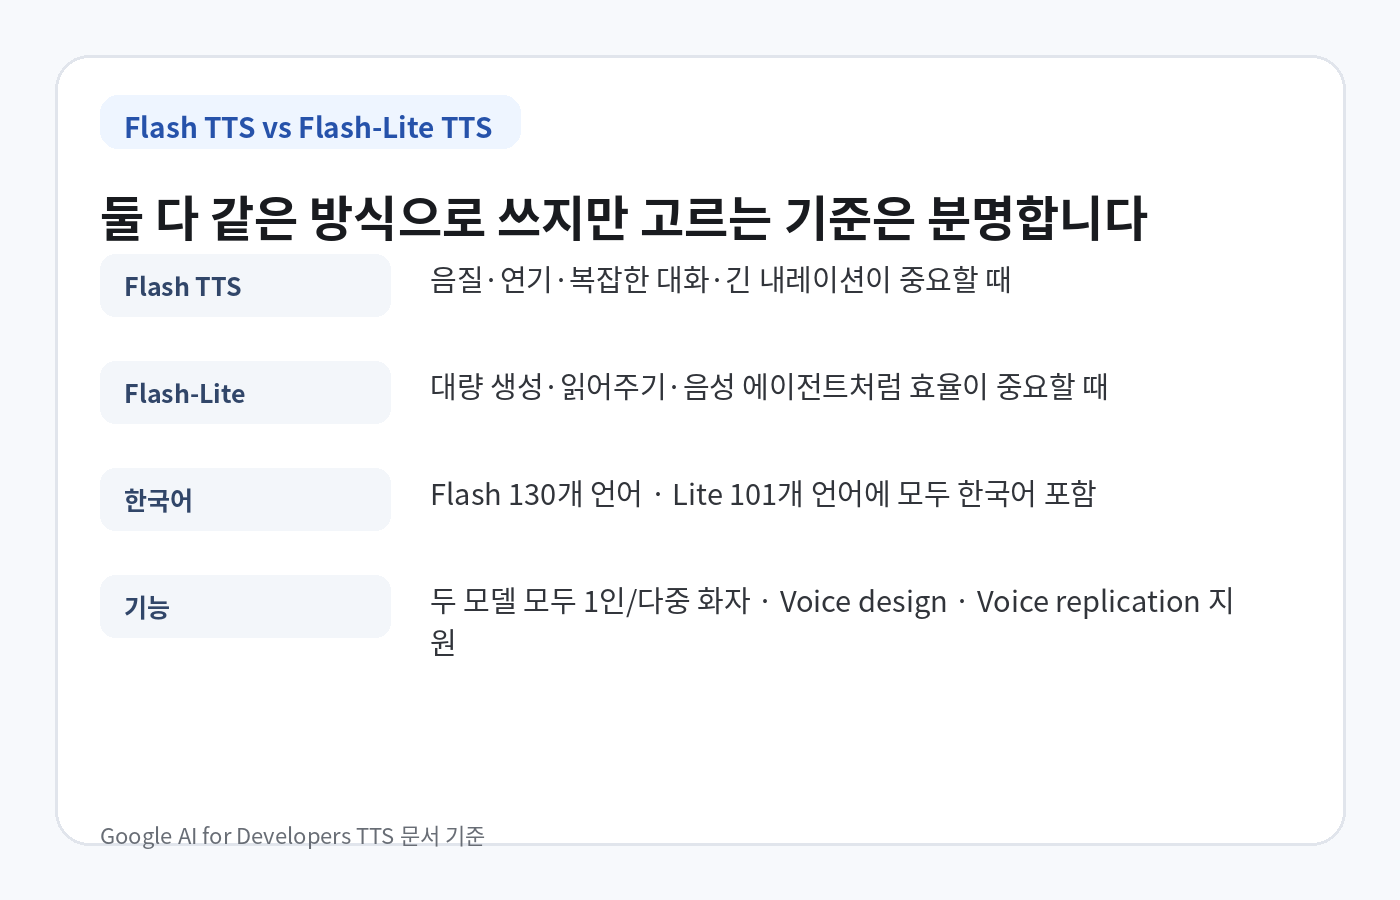
한국어는 두 모델 모두 지원합니다. 공식 TTS 문서 기준 Flash TTS는 130개 언어, Flash-Lite TTS는 101개 언어를 자동 감지하며, 두 지원 목록 모두 Korean이 포함돼 있습니다.
30초 음성으로 복제할 수 있지만, 아무 목소리나 가져오는 기능은 아닙니다
Gemini 3.8 Flash TTS는 본인 목소리나 사용 권리가 있는 목소리의 약 30초 음성 샘플을 기반으로 일관된 음성 프로필을 만들 수 있습니다. 기존 프리셋 중 하나를 고르는 것과 달리 실제 화자의 음색을 유지하는 쪽에 가까운 기능입니다.
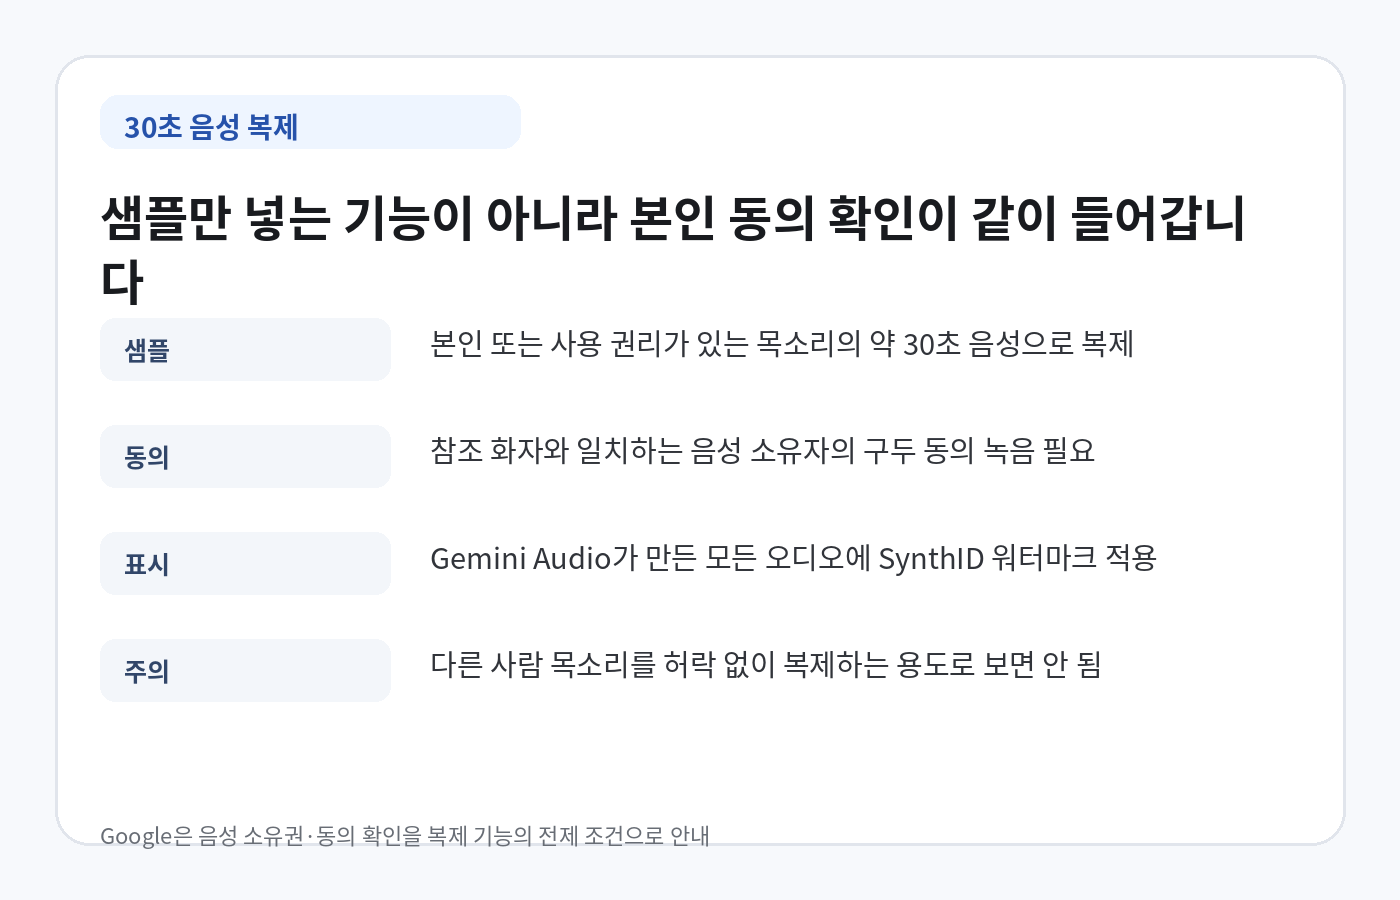
여기서 중요한 건 동의 확인입니다. Google은 음성 복제를 만들 때 참조 화자와 일치하는 음성 소유자의 구두 동의 녹음을 요구한다고 밝혔습니다. 또 Gemini Audio 모델로 생성된 오디오에는 사람이 듣기에는 드러나지 않는 SynthID 워터마크가 적용됩니다.
회사 안내 음성이나 본인 유튜브 내레이션처럼 본인이 직접 쓰는 목소리를 반복 제작하는 데는 꽤 실용적입니다. 반대로 유명인이나 타인의 목소리를 허락 없이 복제하는 식으로 쓰는 기능으로 보면 안 됩니다.
두 사람이 말하는 대화도 한 번에 만들 수 있습니다
예전 TTS는 화자마다 따로 음성을 뽑아 편집 프로그램에서 이어 붙이는 방식이 흔했습니다. Gemini 3.8 TTS는 두 화자의 목소리를 각각 지정하고, 각 대사를 따로 넣은 뒤 한 번에 대화형 오디오로 만들 수 있습니다.
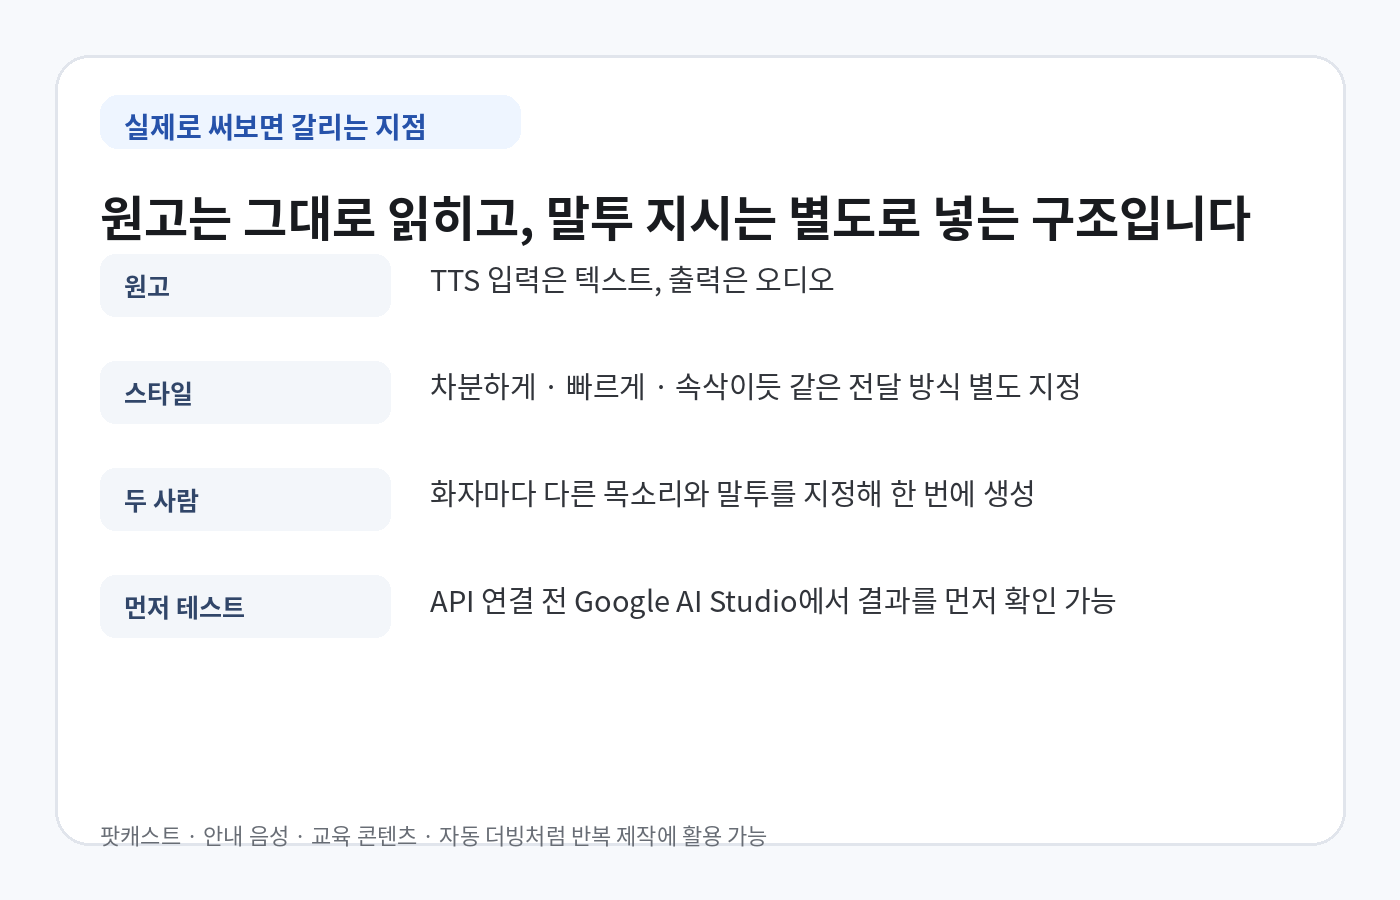
말투 지시도 원고와 분리됩니다. 실제로 읽힐 문장은 그대로 두고, ‘차분하게’, ‘밝고 빠르게’, ‘숨을 고르듯 천천히’ 같은 전달 방식은 별도 스타일 값으로 넣습니다. 중간에 짧은 한숨이나 웃음 같은 순간적인 표현도 태그로 넣을 수 있습니다.
처음 써볼 때는 AI Studio에서 결과부터 확인하는 게 빠릅니다
코드를 바로 붙이기보다 Google AI Studio에서 TTS 모델을 먼저 테스트해 보는 방식이 가장 단순합니다. Google 공식 문서도 실제 개발을 시작하기 전에 AI Studio에서 Gemini TTS 모델을 시험해 볼 수 있다고 안내합니다.
원고를 넣고 목소리와 전달 방식을 바꿔가며 결과를 확인한 뒤, 반복 생성이나 서비스 연동이 필요해질 때 Gemini API로 옮기면 됩니다. 두 모델은 API 구조와 프롬프트 형식이 같아서 모델 이름만 바꾸는 식으로 Flash와 Flash-Lite를 비교하기도 쉽습니다.
다만 이건 대화형 음성 비서와는 성격이 다릅니다. Gemini TTS는 텍스트를 정확히 읽어주는 음성 제작용이고 입력은 텍스트, 출력은 오디오입니다. 실시간으로 말을 주고받는 서비스라면 별도의 Live API가 맞습니다.
어떤 사람에게 바로 쓸 만한가
블로그 글을 음성 콘텐츠로 바꾸거나, 교육 영상 내레이션을 여러 버전으로 만들거나, 안내 방송 문구를 정기적으로 교체하는 작업이라면 바로 체감할 수 있습니다. 특히 원고는 계속 바뀌지만 같은 목소리를 유지해야 하는 업무에서 음성 복제와 저장된 커스텀 보이스가 잘 맞습니다.
작품용 내레이션이나 감정 표현이 많은 콘텐츠는 Flash TTS, 반복 안내와 대량 변환은 Flash-Lite TTS로 시작하면 됩니다. 한국어도 두 모델 모두 지원하므로 국내 콘텐츠를 만들기 위해 별도 언어 모델을 찾을 필요는 없습니다.